JuiceFS 与如何倾倒垃圾
又名:如何优雅地删除 1.3 PB 的垃圾文件。
背景
JuiceFS 是一款面向云原生设计的高性能分布式文件系统,在 Apache 2.0 开源协议下发布。提供完备的 POSIX 兼容性,可将几乎所有对象存储接入本地作为海量本地磁盘使用,亦可同时在跨平台、跨地区的不同主机上挂载读写。
东南大学开源镜像站 (Intranet) 于 2025/09 迁移到新的 JuiceFS 存储后端,整体架构优化后性能符合预期。但经历过一次严重的生产事故后,出于谨慎考虑一直没有升级版本。
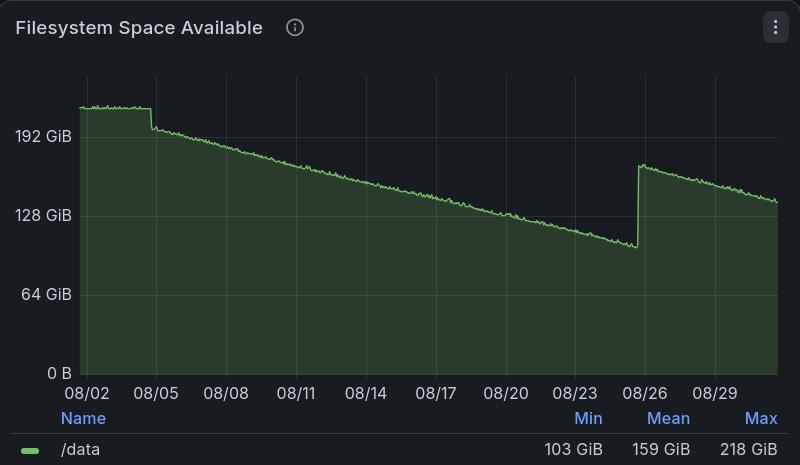
在 2026/08 鼓起勇气平滑升级至 1.4.1 后,后端服务器出现了稳定的存储增长,经排查后确认为 juicefs gc 服务没有正常定期运行。同时,由于镜像站的业务涉及每天千万级的元数据读写,一个月内产生了 >100GiB 的数据库存储占用并持续增加。
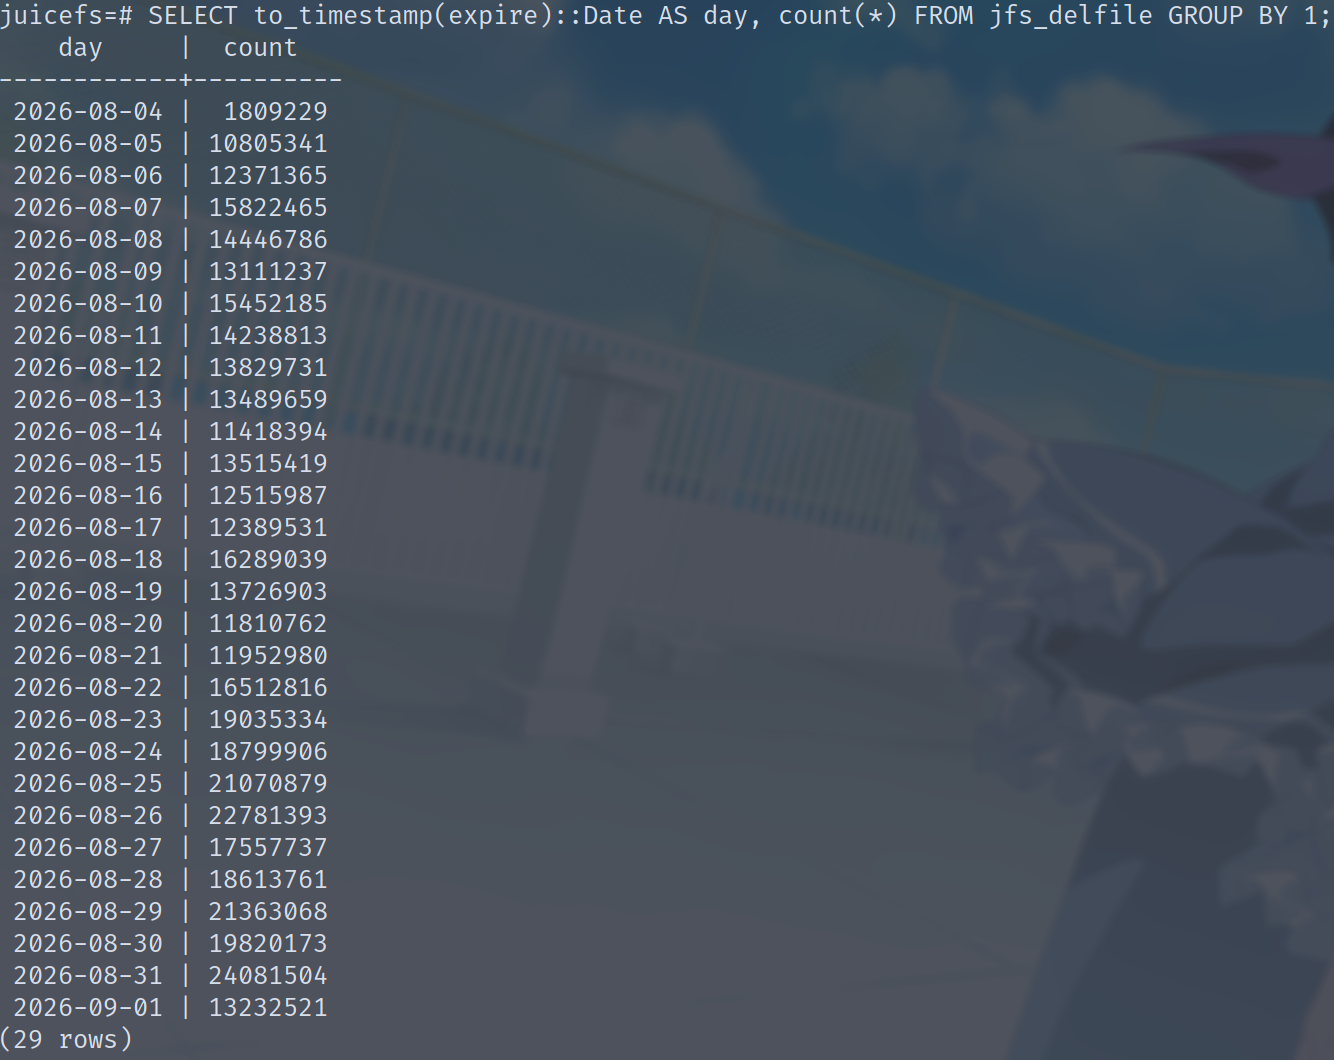
因为现在已经没有人收垃圾了,参考 JuiceFS 内部实现观察各个表结构,可以看到 DB 中已经积累了约4亿个待清理的文件:
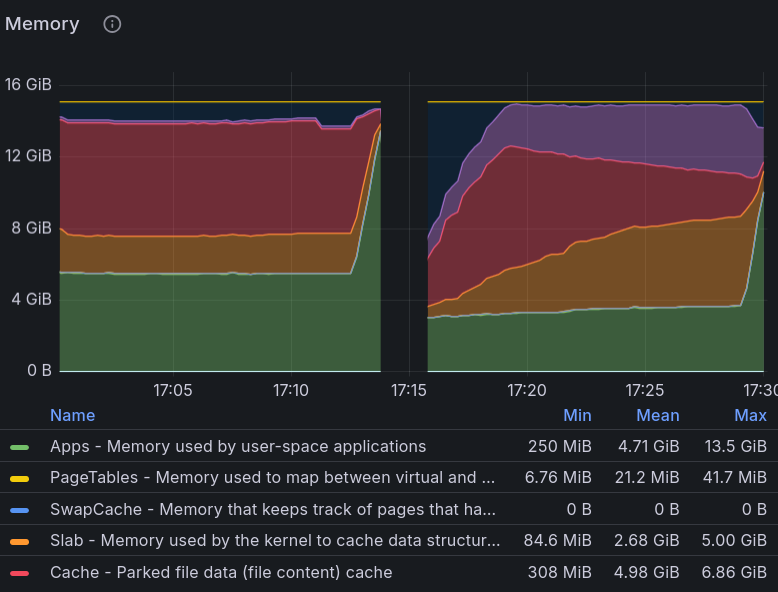
当我们一如既往地尝试重新执行 gc 以清理过期元数据时,不出意外地出意外了:回收过程吃掉了太多内存,直接导致系统 OOM 重启。
定位
因为 juicefs gc 命令会扫描对象存储中的所有对象,所以对于数据量较大的文件系统执行这个命令会有一定开销。另外使用此命令之前请确保您不需要回滚到旧版本元数据,并且建议您备份对象存储数据。
—— 官方文档提示
再一次地,官方文档对此讳莫如深:主线开发版的确提到了可能的性能优化,但在尝试给我们的系统移植所有相关 patch 并启用了 16G swapfile 之后,依然无法解决 gc 吃掉大量内存的问题。
万不得已,还是得读源码 :(
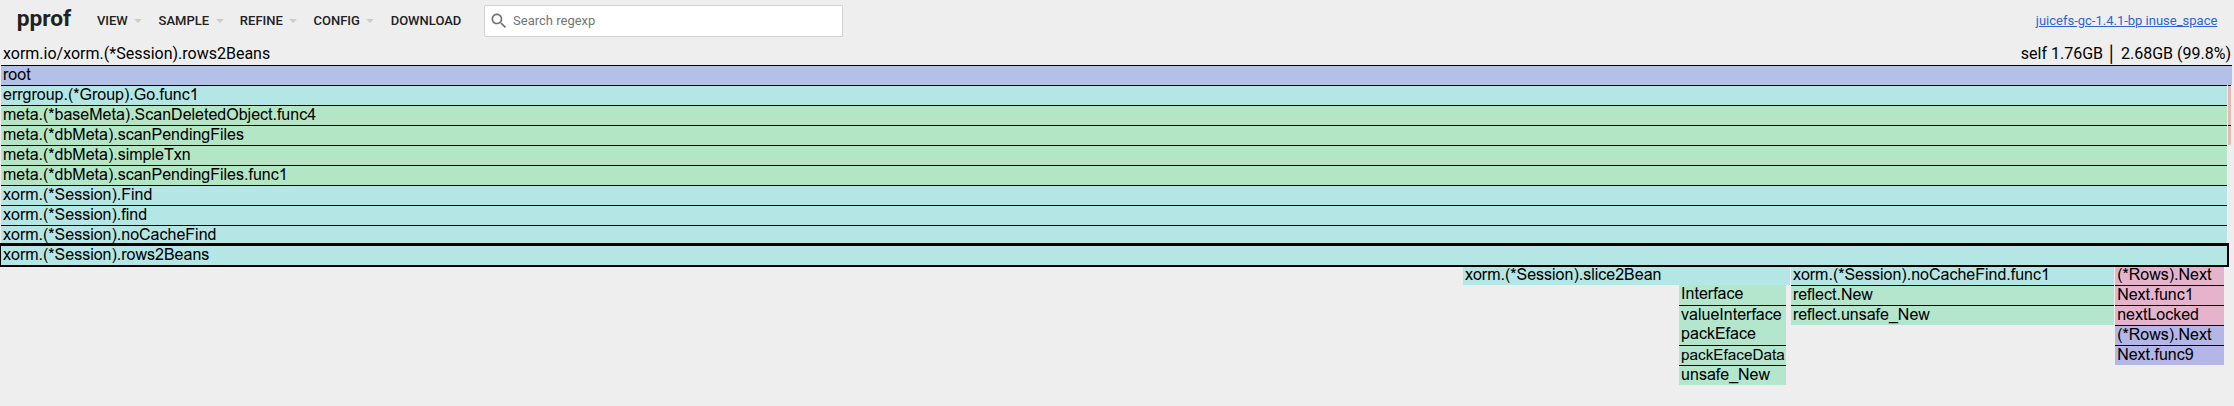
简单修改一下程序,我们可以很方便地开一个用来监控的 Goroutine,在检测到 OOM 前收集一份程序的堆栈采样。不难发现大部分内存都分给了 ScanPendingFiles 下的 xorm.(*Session).Find,它的逻辑大概是这样的:
func (m *dbMeta) scanPendingFiles(ctx Context, scan pendingFileScan) error {
    // ...
	var dfs []delfile
	if err := m.simpleTxn(ctx, func(s *xorm.Session) error {
		if ok, err := s.IsTableExist(&delfile{}); err != nil {
			return err
		} else if !ok {
			return nil
		}
		return s.Find(&dfs)
	}); err != nil {
		return err
	}

	for _, ds := range dfs {
		if _, err := scan(ds.Inode, ds.Length, ds.Expire); err != nil {
			return err
		}
	}

	return nil
}
根据 XORM 文档所示,Find 等同于直接把整个表里的内容都塞到了这个内存的 delfile 数组里。之前执行千万级的加载或许还看不出问题,但考虑到我们上亿的数据量,OOM 也就不足为奇了。
做过优化的朋友们显然能一眼看出问题所在:这个查询完全可以是流式的,类似 JS 的 filter,事实上 XORM 也支持流水线遍历;而更诡异的是在 JuiceFS 仓库的同一个文件里相隔不远的地方也正使用了类似的 Iterate 模式去处理 chunk 表的遍历——不禁让人善意揣测是否是故意留下的坑以推销他的企业版支持。
恢复
参考已有的实现进行修复后,内存占用终于回到了可接受的水平;但由于 jfs_delfile 这张表的数据量还是上亿级的,跑了近一周才最终完成 gc:
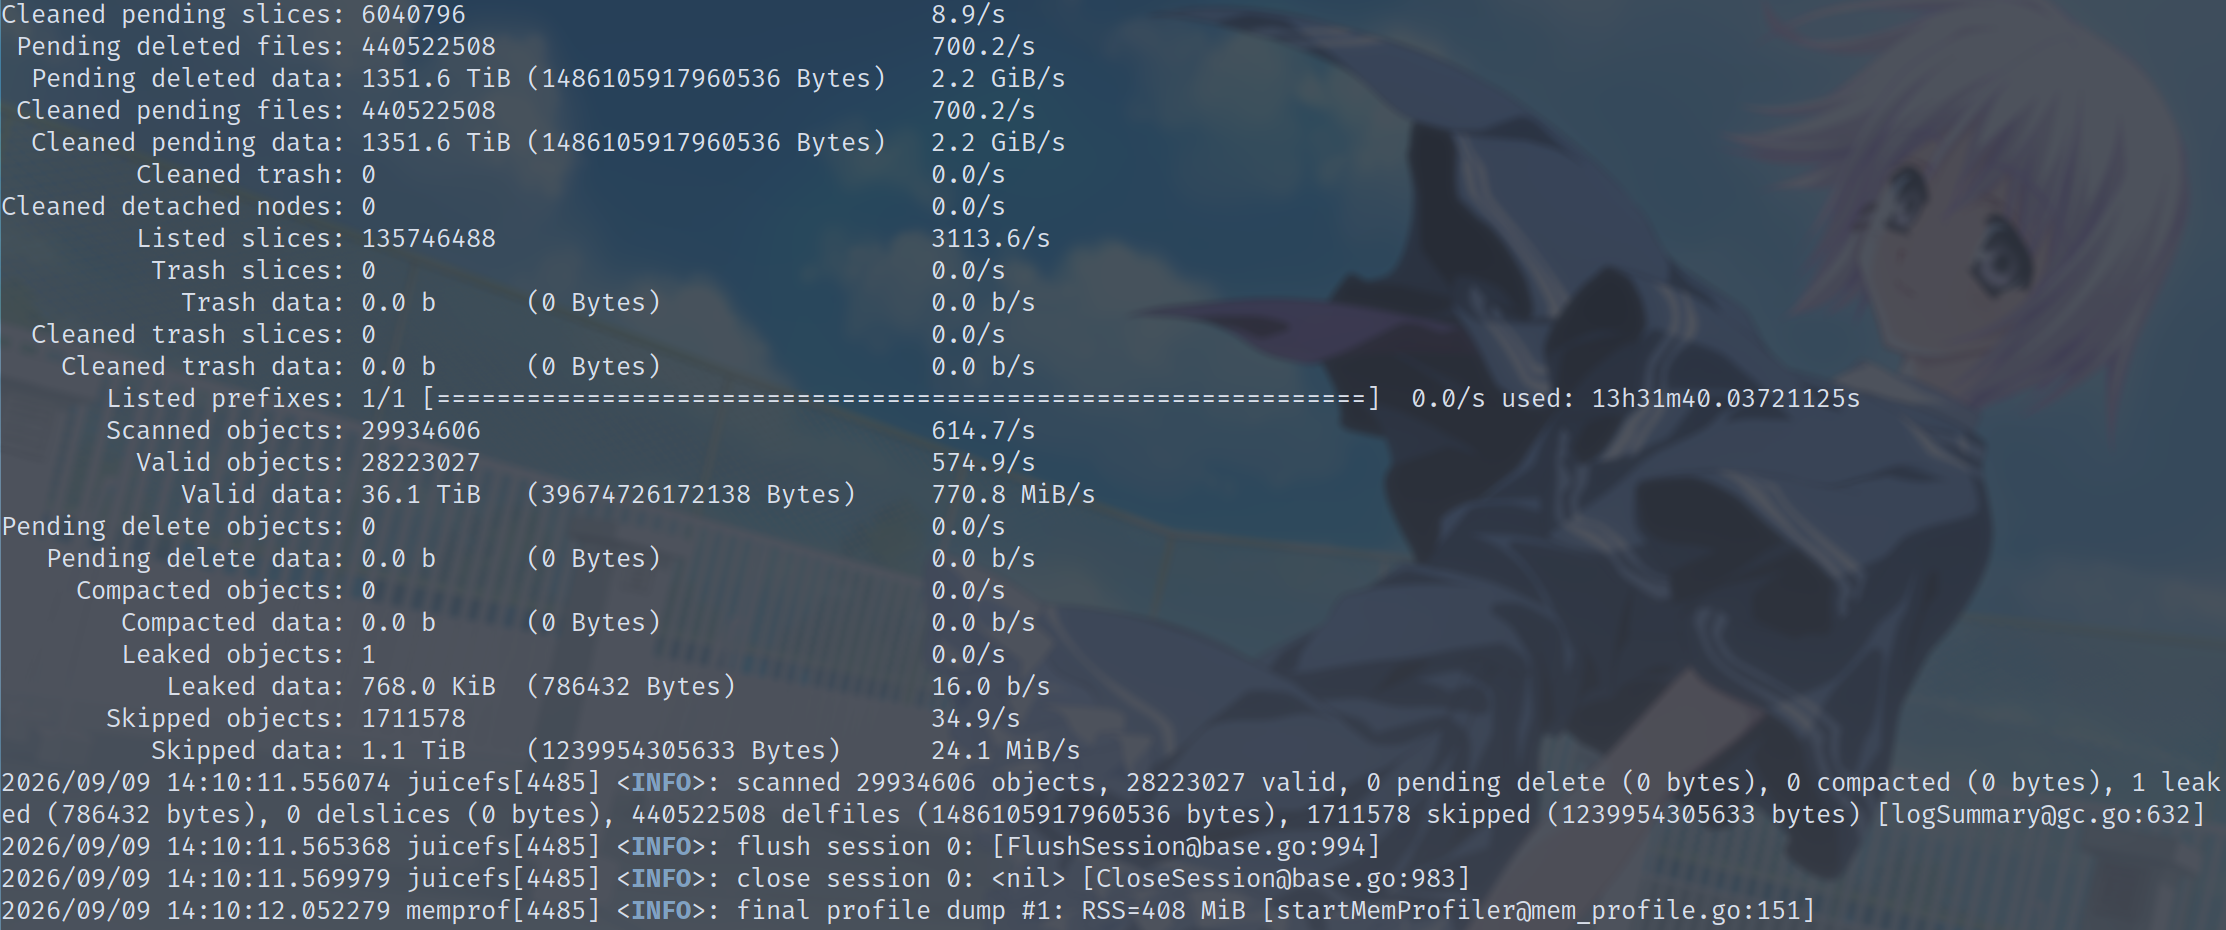
而这还没完,PostgreSQL 内部的垃圾回收需要执行 VACUUM FULL,其要求数据库本身的独占锁,显然对生产业务是不可接受的;还是使用 pg_repack 完成了磁盘回收。
这件事情告诉我们,及时保持环境卫生还是很重要的。